Eksamensoppgavene er utgitt av Utdanningsdirektoratet. Første nedlasting kjører en bot-sjekk i nettleseren (Vercel BotID) — mer i personvernerklæringen.
Oppgave 1-1·Frekvens og relativ frekvens for husarbeid
Lest inn av KI og ikke kontrollert manuelt enda — kan inneholde feil.
Trine har spurt 20 elever i klassen hvor mange ganger de hjalp til med husarbeid hjemme i løpet av en uke. Resultatene ser du nedenfor.
10 14 14 8 5 10 10 10 0 8 8 7 7 0 8 7 7 7 5 7
a)
Bestem medianen, gjennomsnittet, typetallet og variasjonsbredden for dette datamaterialet.
b)
Tegn av og fyll ut tabellen nedenfor.
Forklar hva tallene i nest siste rad i tabellen betyr.
Fasit
a)
Median , gjennomsnitt , typetall , variasjonsbredde
b)
Se utfylt tabell nedenfor. Tallene i nest siste rad viser frekvens – altså antall elever med det aktuelle antallet ganger husarbeid.
LøsningsforslagKI-generert
a)
Vi sorterer de 20 verdiene fra minst til størst:
Median er gjennomsnittet av de to midterste verdiene (plass 10 og 11 når ):
Gjennomsnitt er summen av alle verdier delt på antall verdier:
Typetall er den verdien som forekommer flest ganger. Verdien forekommer 6 ganger, og det er flest.
Variasjonsbredde er differansen mellom største og minste verdi:
Svar: Medianen er , gjennomsnittet er , typetallet er og variasjonsbredden er .
b)
Vi teller opp hvor mange elever som svarte hvert antall ganger og beregner relativ frekvens (andel av 20):
Antall ganger
0
5
7
8
10
14
Frekvens
2
2
6
4
4
2
Relativ frekvens
Tallene i nest siste rad (frekvens) viser antall elever som hjalp til hjemme det aktuelle antallet ganger i løpet av uken. For eksempel hjalp 6 elever til hjemme 7 ganger i løpet av uken.
Relativ frekvens regnes ut ved å dele frekvensen på totalt antall elever (20). For eksempel er relativ frekvens for 7 ganger:
Det betyr at av elevene hjalp til 7 ganger i løpet av uken.
Oppgave 1-2·Flybuss og bybane – prosentvis prisforskjell
Lest inn av KI og ikke kontrollert manuelt enda — kan inneholde feil.
For å reise til flyplassen kan Herman ta flybussen eller bybanen.
Flybussen koster 100 kroner, og bybanen koster 40 kroner.
a)
Hvor mange prosent billigere er bybanen sammenlignet med flybussen?
b)
Hvor mange prosent dyrere er flybussen sammenlignet med bybanen?
Fasit
a)
Bybanen er billigere enn flybussen.
b)
Flybussen er dyrere enn bybanen.
LøsningsforslagKI-generert
a)
Vi sammenligner bybanen med flybussen. Referansen er flybussen ().
Prisforskjellen er:
Vi finner hvor mange prosent er av :
Svar: Bybanen er billigere enn flybussen.
b)
Vi sammenligner flybussen med bybanen. Nå er referansen bybanen ().
Prisforskjellen er fortsatt , men nå deler vi på bybanens pris:
Svar: Flybussen er dyrere enn bybanen.
Merk at svaret blir ulikt i a) og b) selv om prisforskjellen er den samme – det er fordi vi bruker ulikt referansegrunnlag (flybussen i a, bybanen i b).
Oppgave 1-3·Lineær og eksponentiell vekst forklart med eksempel
Lest inn av KI og ikke kontrollert manuelt enda — kan inneholde feil.
Forklar forskjellen mellom lineær og eksponentiell vekst.
Ta med et eksempel på lineær vekst og et eksempel på eksponentiell vekst i forklaringen din.
Fasit
Se løsningsforslag – oppgaven ber om forklaring med eksempler.
LøsningsforslagKI-generert
Lineær vekst betyr at noe øker med like mye for hvert steg. Økningen er den samme hver gang.
Eksempel på lineær vekst: Du sparer ekstra hver måned. Etter 1 måned har du spart , etter 2 måneder , etter 3 måneder – og slik fortsetter det. Du sparer alltid mer per måned, uansett hvor mye du allerede har spart.
Eksponentiell vekst betyr at noe øker med en fast prosent for hvert steg. Økningen blir større og større fordi du tar prosenten av et stadig større tall.
Eksempel på eksponentiell vekst: Du setter i banken med rente per år. Etter 1 år har du , etter 2 år , etter 3 år . Du tjener mer renter hvert år fordi renten regnes av et større beløp.
Oppsummering:
Lineær vekst: like stor økning hvert steg (f.eks. )
Eksponentiell vekst: like stor prosentvis økning hvert steg (f.eks. )
Oppgave 1-5·Gjennomsnitt og histogram for kartleggingsprøve
Lest inn av KI og ikke kontrollert manuelt enda — kan inneholde feil.
Tabellen nedenfor viser poengfordelingen på en kartleggingsprøve i matematikk i 2P-gruppene ved en skole.
Poeng
Antall elever
4
12
34
30
20
a)
Bestem gjennomsnittet for dette datamaterialet.
b)
Lag et histogram som viser fordelingen av poeng.
Fasit
a)
b)
Se histogram i løsningsforslag.
LøsningsforslagKI-generert
a)
Vi bruker midtpunktet i hvert intervall som representativ verdi for intervallet. Det siste intervallet har bredde 20, og midtpunktet er .
Intervall
Midtpunkt
Antall elever
Sum
Gjennomsnittet er .
b)
I et histogram skal søylebredden tilsvare intervallbredden, og søylehøyden vise frekvenstetthet (antall per poengenhet). Her er de fleste intervallene poeng brede, men det siste er poeng bredt.
Vi beregner frekvenstetthet = antall elever ÷ intervallbredde:
Intervall
Bredde
Antall
Frekvenstetthet
Histogrammet tegnes med poeng langs -aksen og frekvenstetthet langs -aksen. Søylen over er dobbelt så bred som de andre, men halvparten så høy som antallet skulle tilsi, slik at arealet (= bredde × høyde) stemmer med antall elever.
Lest inn av KI og ikke kontrollert manuelt enda — kan inneholde feil.
En båt har i dag en verdi på 200 000 kroner. Anta at båtens verdi synker med hvert år framover.
a)
Sett opp et uttrykk som du kan bruke til å regne ut hvor mye båten vil være verdt om 10 år.
Anders påstår at båtens verdi vil være 100 000 kroner etter 10 år.
b)
Forklar Anders hvorfor dette ikke kan være riktig.
Fasit
a)
b)
Verdien etter 10 år er ca. , ikke .
LøsningsforslagKI-generert
a)
Båten mister av verdien hvert år. Det betyr at den beholder av verdien hvert år. Vekstfaktoren er .
Etter 10 år er verdien:
Uttrykket er .
b)
Vi regner ut verdien etter 10 år:
Anders sier verdien vil være , altså nøyaktig halvparten av startprisen.
For at verdien skulle halvere seg til , måtte det bety at av verdien forsvinner etter 10 år. Men et verdifall på per år er ikke det samme som et samlet verdifall på etter 10 år. Hvert år regnes fallet av den gjenværende verdien, ikke av den opprinnelige prisen. Dermed faller verdien saktere og saktere for hvert år.
Etter 10 år er verdien ca. , ikke . Anders tar feil.
Oppgave 1-7·Figurmønster med grønne og hvite kvadrater
Lest inn av KI og ikke kontrollert manuelt enda — kan inneholde feil.
Ovenfor ser du tre figurer. Figurene er satt sammen av små hvite kvadrater og små grønne kvadrater. Tenk deg at du skal fortsette å lage figurer etter samme mønster.
a)
Hvor mange små grønne kvadrater vil det være i figur 10?
Sett opp et regnestykke som viser hvordan du har tenkt for å komme fram til dette svaret.
b)
Bestem et uttrykk for antallet små grønne kvadrater når antall små hvite kvadrater er .
Fasit
a)
b)
LøsningsforslagKI-generert
a)
Vi teller antall grønne og hvite kvadrater i hver figur:
Figur
Hvite kvadrater
Grønne kvadrater
Totalt
1
2
3
Vi ser at antall grønne kvadrater øker med for hver ny figur:
Figur 10 har hvite kvadrater, og vi kan telle oss frem:
Alternativt: fra figur 1 til figur 10 øker vi med steg à :
I figur 10 er det .
b)
Vi kaller antall hvite kvadrater for , der
Fra tabellen over ser vi at antall grønne kvadrater er:
Vi kan også forstå det geometrisk: hvert av de fire sidene i den grønne rammen har kvadrater, men hjørnene telles to ganger. Da er .
Lest inn av KI og ikke kontrollert manuelt enda — kan inneholde feil.
Funksjonene og gitt ved
viser tilnærmet daglengde, minutter i Mandal og minutter i Trondheim, døgn etter 31. desember 2018.
a)Hjelpemiddelkrav: Kalkulator
Tegn grafene til og i samme koordinatsystem.
b)Hjelpemiddelkrav: Krever PC
Når var daglengden lik i de to byene?
c)Hjelpemiddelkrav: Kalkulator
Hvor mange minutter økte daglengden i Mandal i gjennomsnitt med per dag fra 31. desember til 1. mai?
d)Hjelpemiddelkrav: Krever PC
Bestem den momentane vekstfarten til funksjonen når .
Gi en praktisk tolkning av dette svaret.
Fasit
a)
Se graf under.
b)
Daglengden var lik ca. , dvs. rundt 20. mars.
c)
d)
LøsningsforslagKI-generert
a)
Vi skriver inn funksjonene i GeoGebra og tegner grafene i samme koordinatsystem:
M(x) = If(0 <= x && x <= 190, -0.0002*x^3 + 0.046*x^2 + 2*x + 396)T(x) = If(0 <= x && x <= 190, -0.00028*x^3 + 0.066*x^2 + 2.2*x + 295)Skjaering = Intersect(M, T, 0, 190)ZoomIn(0, 200, 200, 1100)
(blå) og (grønn) viser daglengden i henholdsvis Mandal og Trondheim, der er antall dager etter 31. desember 2018.
Vi ser at:
Begge grafene starter med ulik verdi ved : Mandal har minutter, Trondheim har minutter.
Daglengden øker for begge byer utover i perioden.
Trondheim () øker raskere enn Mandal () i begynnelsen av perioden.
b)
Vi bruker GeoGebra til å finne skjæringspunktet mellom og .
GeoGebra gir at grafene skjærer hverandre ved
svarer til omtrent 20. mars 2019 (31 dager i januar + 28 dager i februar + 20 dager i mars = 79 dager).
Daglengden var lik i Mandal og Trondheim rundt 20. mars 2019, med om lag minutters daglengde.
c)
Gjennomsnittlig vekstfart er definert som:
Vi beregner fra 31. desember () til 1. mai.
Fra 31. desember til 1. mai er det dager, altså .
Vi regner ut:
Gjennomsnittlig vekstfart:
Daglengden i Mandal økte i gjennomsnitt med omtrent minutter per dag fra 31. desember til 1. mai.
Dette betyr at for hver dag som gikk i dette tidsrommet, ble dagen i gjennomsnitt nesten 5 minutter lengre.
d)
Den momentane vekstfarten til ved er det samme som den deriverte .
Vi deriverer :
Vi setter inn :
Den momentane vekstfarten er .
svarer til omtrent 1. mars 2019 (31 januar + 28 februar + 1 mars = 60 dager).
Praktisk tolkning: Den 1. mars 2019 økte daglengden i Trondheim med omtrent minutter per dag. Det betyr at dagene ble lenger med nesten minutters hastighet akkurat da.
Lest inn av KI og ikke kontrollert manuelt enda — kan inneholde feil.
Tabellen nedenfor viser hvor mange passasjerer som reiste med fly fra Oslo til Stavanger, Bergen og Trondheim i perioden fra 1. april til 30. juni, i 2018 og i 2019.
Antall passasjerer 1. april–30. juni
Flyruter
2018
2019
Oslo–Stavanger
223 653
215 615
Oslo–Bergen
270 427
255 117
Oslo–Trondheim
281 429
263 853
Bruk tallene i tabellen til å lage to ulike diagrammer.
Det første diagrammet skal vise endring i antall passasjerer fra 2018 til 2019 for hver av de tre flyrutene.
Det andre diagrammet skal vise den prosentvise fordelingen av passasjerer mellom de tre flyrutene i 2019.
Lag de to diagrammene.
Fasit
Diagram 1: Søylediagram med endring i antall passasjerer (alle ruter: nedgang).
Diagram 2: Sektordiagram (eller søylediagram) med prosentvis fordeling i 2019: Oslo–Stavanger , Oslo–Bergen , Oslo–Trondheim .
LøsningsforslagKI-generert
Forberedelse – beregn tallene
Endring fra 2018 til 2019:
Flyrute
2018
2019
Endring
Oslo–Stavanger
223 653
215 615
Oslo–Bergen
270 427
255 117
Oslo–Trondheim
281 429
263 853
Prosentvis fordeling i 2019:
Totalt antall passasjerer i 2019:
Flyrute
Antall 2019
Andel
Oslo–Stavanger
215 615
Oslo–Bergen
255 117
Oslo–Trondheim
263 853
Diagram 1 – Endring i antall passasjerer (søylediagram)
I GeoGebra velger du Regneark og legger inn dataene:
Kolonne A
Kolonne B
Oslo–Stavanger
−8 038
Oslo–Bergen
−15 310
Oslo–Trondheim
−17 576
Merk kolonne B, velg Ett variabelt diagram → Søylediagram. Gi diagrammet tittel «Endring i antall passasjerer 2018–2019».
Alle tre rutene hadde nedgang i passasjertall fra 2018 til 2019. Oslo–Trondheim hadde størst nedgang ( passasjerer), etterfulgt av Oslo–Bergen () og Oslo–Stavanger ().
Diagram 2 – Prosentvis fordeling i 2019 (sektordiagram)
I GeoGebra velger du Regneark og legger inn:
Kolonne A
Kolonne B
Oslo–Stavanger
29,4
Oslo–Bergen
34,7
Oslo–Trondheim
35,9
Merk begge kolonner, velg To variable → Sektordiagram. Gi diagrammet tittel «Prosentvis fordeling av passasjerer i 2019».
Svar: I 2019 hadde Oslo–Trondheim størst andel av passasjerene med , mens Oslo–Stavanger hadde minst andel med .
Oppgave 2-4·Hoppekreps – lineær og eksponentiell modell med regresjon
Lest inn av KI og ikke kontrollert manuelt enda — kan inneholde feil.
Lars og Lene forsker på hvordan antallet hoppekreps i et ferskvann endrer seg.
Tabellen nedenfor viser antall observerte hoppekreps noen dager i april og mai.
Dato
30.04
03.05
04.05
06.05
Antall hoppekreps
10 000
20 000
30 000
120 000
Ut fra disse observasjonene vil Lars og Lene lage ulike modeller.
De lar være antall dager etter 30. april.
Når Lars lager sin modell, antar han at antallet hoppekreps øker med et fast antall hver dag.
a)Hjelpemiddelkrav: Kalkulator
Bestem modellen han da får.
Gjør rede for hva hvert av tallene i modellen betyr i denne praktiske situasjonen.
Når Lene lager sin modell, antar hun at antallet hoppekreps øker med en fast prosent hver dag.
b)Hjelpemiddelkrav: Kalkulator
Bestem modellen hun da får.
Gjør rede for hva hvert av tallene i modellen betyr i denne praktiske situasjonen.
Ved å bruke regresjon har Lene i tillegg funnet modellen gitt ved
c)Hjelpemiddelkrav: Krever PC
Vis hvordan hun har gått fram for å finne denne modellen.
d)Hjelpemiddelkrav: Krever PC
Tegn grafen til modellen fra oppgave b) og grafen til i samme koordinatsystem, og beskriv forskjeller og likheter mellom de to modellene.
Fasit
a)
(lineær regresjon)
b)
(eksponentiell regresjon)
c)
Tredjegradsregresjon i GeoGebra gjennom alle fire datapunkter gir
d)
Se graf. Kubikkmodellen treffer alle fire datapunkter nøyaktig, mens den eksponentielle bommer litt på punktene. Begge vokser raskt for store .
LøsningsforslagKI-generert
a)
Lars antar at antallet hoppekreps øker med et fast antall per dag. Det betyr at han bruker en lineær modell. Siden vi har fire datapunkter og hjelpemidler, bruker vi lineær regresjon i GeoGebra.
Vi fører datapunktene , , og inn i regnearket og velger regresjonsanalyse med lineær modell. GeoGebra gir:
Hva tallene betyr:
er den daglige økningen i antall hoppekreps (stigningstallet).
har ingen praktisk betydning. Et konstantledd skulle vært antallet hoppekreps på dag , men dette tallet er negativt, og et antall hoppekreps kan ikke være negativt (vi vet dessuten at det var den 30. april). Modellen treffer altså ikke datamaterialet særlig godt.
b)
Lene antar at antallet hoppekreps øker med en fast prosent per dag. Det betyr at hun bruker en eksponentiell modell av typen . Vi bruker samme datapunkter, men velger eksponentiell regresjon i GeoGebra:
Hva tallene betyr:
er startverdien. Ifølge Lenes modell var det omtrent hoppekreps på dag (30. april), noe som ikke avviker så mye fra det riktige antallet .
er vekstfaktoren per dag. Siden , betyr det at antallet øker med omtrent per dag.
c)
For å finne kubikkmodellen bruker Lene regresjon i GeoGebra.
Fremgangsmåte i GeoGebra:
Skriv inn datapunktene som en liste i GeoGebra:
Bruk regresjonskommandoen for tredjegradspolynom:
GeoGebra beregner koeffisientene ved å løse et likningssystem med fire ligninger (ett for hvert datapunkt) og fire ukjente (, , , ).
Verifisering: Siden vi har nøyaktig fire datapunkter og fire koeffisienter, går kubikkmodellen gjennom alle punktene eksakt:
Observert
Resultatet er:
d)
Vi tegner grafene til og i GeoGebra, sammen med de fire datapunktene.
I GeoGebra:
Skriv inn (blå kurve)
Skriv inn (grønn kurve)
Legg inn datapunktene , , ,
Likheter og forskjeller:
Likheter:
Begge modellene starter omtrent ved riktig startverdi ( og ) den 30. april.
Etter begge modellene vil bestanden øke kraftig og vokse over alle grenser etter noen få dager.
Forskjeller:
(kubikkmodellen) treffer alle fire datapunkter nøyaktig, mens bommer litt på punktene.
har et lokalt toppunkt rundt dag og synker litt før den stiger igjen. Ifølge denne modellen skulle altså bestanden gå litt ned før den øker — noe som neppe stemmer med virkeligheten.
er en jevn, alltid voksende og alltid positiv kurve, og er på den måten mer realistisk i formen — den har hatt et visst antall hoppekreps hele tiden som bestanden kan utvikle seg fra.
Oppgave 2-5·Karakterfordeling i matematikk og norsk – standardavvik
Lest inn av KI og ikke kontrollert manuelt enda — kan inneholde feil.
Diagrammene ovenfor viser karakterfordelingen for 10. trinn i matematikk og norsk hovedmål våren 2019.
a)Hjelpemiddelkrav: Kalkulator
Bestem gjennomsnittskarakteren i matematikk og gjennomsnittskarakteren i norsk.
b)Hjelpemiddelkrav: Kalkulator
Hvordan kan du ut fra diagrammene argumentere for at standardavviket i matematikk er større enn standardavviket i norsk?
c)Hjelpemiddelkrav: Kalkulator
Hvilken/hvilke av påstandene nedenfor er riktig/riktige?
Husk å begrunne svarene dine.
1)
Dersom gjennomsnittet for et datasett A er høyere enn gjennomsnittet for et datasett B, vil standardavviket for A alltid være lavere enn standardavviket for B.
2)
Dersom standardavviket for et datasett er lik null, er alle verdiene i datasettet like.
Fasit
a)
Matematikk: , norsk:
b)
Matematikk har større spredning rundt gjennomsnittet enn norsk – se argumentasjon under.
c)
Påstand 1 er feil. Påstand 2 er riktig.
LøsningsforslagKI-generert
a)
Vi leser av prosentandelene fra diagrammene og regner ut gjennomsnittet som et vektet gjennomsnitt.
Matematikk:
Karakter
Andel
1
2
3
4
5
6
Norsk:
Karakter
Andel
1
2
3
4
5
6
Gjennomsnittskarakteren er i matematikk og i norsk.
b)
Standardavviket sier noe om hvor spredt karakterene er rundt gjennomsnittet. Jo mer spredt fordelingen er, desto større er standardavviket.
I matematikk er fordelingen relativt jevnt fordelt over alle karakterer fra 1 til 6 – mange elever har fått karakterene 1 og 2 (til sammen nesten ), og relativt mange har fått 5 og 6. Fordelingen er bred og flat.
I norsk er fordelingen mer samlet rundt midten: karakteren 4 dominerer sterkt (), karakterene 3 og 5 er de nest vanligste, mens det er svært få elever med 1 og 2 (til sammen bare ). Fordelingen er smalere og mer klokkeformet.
Siden karakterene i matematikk er mer spredt fra gjennomsnittet enn i norsk, er standardavviket større i matematikk.
(For den som vil kontrollere: og .)
c)
Påstand 1 er feil.
Et høyere gjennomsnitt sier ingenting om spredningen. For eksempel kan datasett A = {4, 4, 4} ha gjennomsnitt 4 og standardavvik 0, mens datasett B = {1, 3, 6} har gjennomsnitt og standardavvik større enn 0. Her er gjennomsnittet for A høyere enn for B, men standardavviket for A er lavere – ikke høyere. Motsatt kunne vi hatt tilfeller der høyere gjennomsnitt gir høyere standardavvik. Det er ingen fast sammenheng mellom gjennomsnitt og standardavvik.
Påstand 2 er riktig.
Standardavviket måler gjennomsnittlig avstand fra gjennomsnittet. Hvis alle verdiene i datasettet er like, er alle avstandene fra gjennomsnittet lik null, og dermed er standardavviket . Omvendt: hvis standardavviket er null, kan ingen verdi avvike fra gjennomsnittet, så alle verdiene må være like.
Oppgave 2-7·Identifisere graf for eksponentiell nedgang
Hjelpemiddelkrav: For hånd
Lest inn av KI og ikke kontrollert manuelt enda — kan inneholde feil.
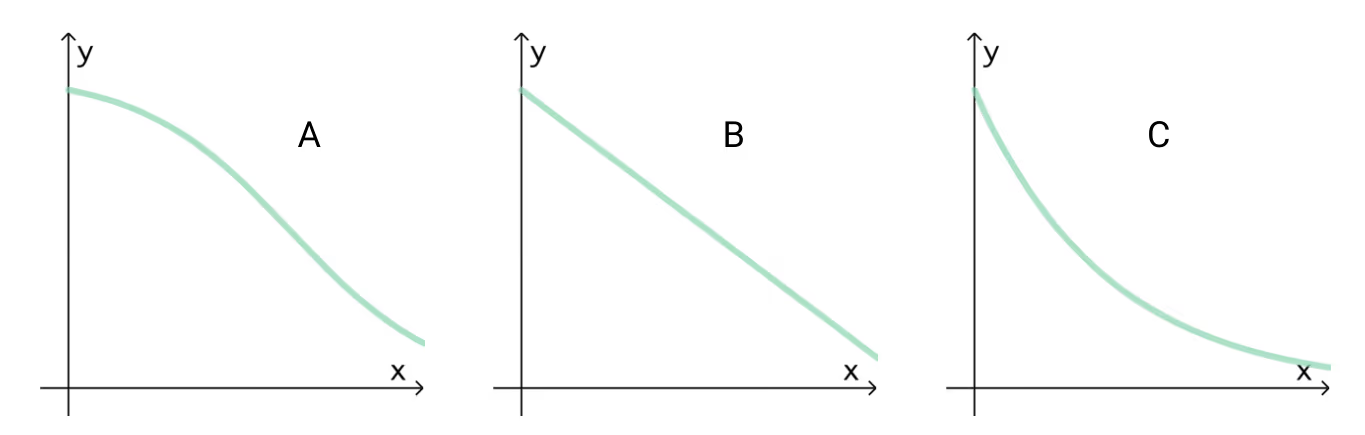
En størrelse avtar eksponentielt.
Hvilken av grafene illustrerer at størrelsen avtar eksponentielt? Begrunn svaret.
Fasit
LøsningsforslagKI-generert
Når en størrelse avtar eksponentielt, kan den skrives som der . En slik funksjon har to kjennetegn:
Verdien minker prosentvis likt for hver x-enhet. Det betyr at den minker mye i starten (når verdien er stor), og stadig mindre etter hvert som verdien blir mindre.
Grafen flater ut og nærmer seg x-aksen uten noen gang å nå den (den er alltid positiv).
Vi ser på de tre grafene:
synker sakte i starten og brattere mot slutten. Det er motsatt av eksponentiell nedgang, og passer ikke.
er en rett linje, altså en lineær nedgang med konstant fall for hver x-enhet. En rett linje har ikke den avtagende endringsraten som kjennetegner eksponentiell nedgang.
synker raskt i starten og flater gradvis ut mot x-aksen uten å nå den. Dette stemmer med at en eksponentielt avtagende størrelse minker mest når verdien er stor, og mindre og mindre etter hvert.
Grafen som illustrerer at størrelsen avtar eksponentielt, er derfor graf C.
Oppgave 2-8·Lønnsøkning over to år for Svein og Tore
Hjelpemiddelkrav: Kalkulator
Lest inn av KI og ikke kontrollert manuelt enda — kan inneholde feil.
Svein og Tore hadde lik lønn i 2017.
Svein fikk lønnsøkning i 2018 og lønnsøkning i 2019.
Tore fikk lønnsøkning i 2018 og lønnsøkning i 2019.
Hvem av de to hadde høyest lønn i 2019?
Fasit
LøsningsforslagKI-generert
Svein og Tore hadde lik lønn i 2017. Vi kaller denne lønnen .
Når en størrelse øker med , multipliserer vi med vekstfaktoren . Siden begge fikk to lønnsøkninger etter hverandre, må vi multiplisere de to vekstfaktorene for å finne lønnen i 2019.
Svein fikk økning i 2018 og økning i 2019:
Tore fikk økning i 2018 og økning i 2019:
Siden begge startet med samme lønn , kan vi sammenligne de samlede vekstfaktorene direkte:
Svein sin samlede vekstfaktor er størst, altså hadde Svein høyest lønn i 2019.